
本章从一次类型化判断开始,理解 State、Noul、Choice 和 Score,再通过客服工单与赛事指挥台实验观察模型判断如何进入程序。环境配置、中转站接入和离线替身是本次学习中的实践记录;示例地址与密钥均为占位符。
一、认识 Jev
Jev 是 TypeSafe 的判断模型。与主要输出自由文本的生成式模型相比,本章关注的是答案范围明确的判断:是否成立、属于哪一类、程度有多高。
它接收状态证据(State)和类型化问题,返回结构化答案及概率信息,再由普通代码决定后续动作。
State 提供证据 → 原语定义问题与答案空间 → 模型返回判断 → 代码执行策略比如说,面对一条客服工单,我们可以判断它属于什么类别、有多紧急、是否需要人工处理,再由程序安排处理流程。模型负责语义判断,阈值、路由和执行规则由代码掌握。
本章的两个例子分别是:
- 客服工单:对同一段文字同时判断紧迫性、主要诉求和受挫程度。
- 赛事指挥台:判断事件类别、优先级和是否需要人工,再根据结果分流。
学习时先运行原例子,再只改一个因素,观察输入、概率与最终动作之间的关系。离线数据只能观察程序路径;研究模型对输入变化的反应需要真实调用。
二、在 VS Code 中使用项目环境
1. 创建环境
在项目 main/ 目录运行:
./setup_env.sh脚本创建 main/.venv,优先使用 uv 创建 Python 3.12 环境;没有 uv 时寻找已有的 Python 3.10~3.13 解释器。依赖中已包含 JupyterLab 和 ipykernel。
第一章安装单元格指定 typesafe-sdk==0.7.0,但只在未安装 SDK 时执行;环境脚本的依赖是 typesafe-sdk>=0.7,所以实际安装版本未必恰好为 0.7.0。可以在内核中查看:
from importlib.metadata import version

print(version("typesafe-sdk"))
本文保留本次教程用法,不要求升级。接口说明结合仓库代码与官方当前文档核对,未对历史 0.7.0 的全部行为重新验收。
2. 选择 Notebook 内核
- 安装微软的 Python 和 Jupyter 扩展。
- 用
Python: Select Interpreter选择main/.venv/bin/python;未识别时手动输入路径。 - 打开
.ipynb,点击右上角Select Kernel,通过Select Another Kernel… → Python Environments选择同一环境。 - 运行下面的代码确认内核:
import sys

print(sys.executable)
预期路径为项目中的 main/.venv/bin/python。Python 解释器选择与 Notebook 内核选择需要分别确认。
如果环境创建在 WSL 中,VS Code 也应在 WSL 窗口中打开项目,并在 WSL 侧安装扩展。无需额外启动 jupyter lab。
3. 安装包名与导入名
python-dotenv 是安装包名,dotenv 是 Python 导入名,所以检测时应写:
import importlib.util

if importlib.util.find_spec("dotenv") is None:
%pip install python-dotenv同样,typesafe-sdk 的导入名是 typesafe_sdk。这里的 %pip 是 Notebook 魔法命令,用于向当前内核环境安装依赖,不能直接当成普通 .py 语法使用。
三、读取配置与接入中转站
1. 终端环境变量的继承
终端里的 export 只影响当前 shell 和它之后启动的子进程,不会反向修改已经运行的 VS Code 或 Notebook 内核。
因此,在 VS Code 内置终端设置变量,再重启 Notebook 内核,通常不足以完成传递。可以完整退出 VS Code,从配置好变量的外部终端启动;已有 VS Code 进程复用时仍可能无法继承。
这里采用 .env 主动加载,配置关系更直接。
2. 创建 .env
在 main/.env 中填写:
TYPESAFE_BASE_URL=https://relay.example.com
TYPESAFE_API_KEY=YOUR_API_KEY_HERE
TYPESAFE_DEFAULT_MODEL=jev-latest
JEV_RUN_MODE=live
真实密钥只放在本地配置中,不写进 Notebook 或笔记。仓库已有 **/.env 忽略规则;忽略规则不会自动移除已经被 Git 跟踪的文件。
3. 在客户端初始化之前加载
安装 python-dotenv 后,增加一个单元格:
import os
from pathlib import Path
from dotenv import load_dotenv

env_path = Path(
    "../.env"
)

if not env_path.is_file():
    raise FileNotFoundError(f"找不到配置文件:{env_path}")

load_dotenv(env_path, override=True)
print("已配置密钥:", bool(os.getenv("TYPESAFE_API_KEY")))
override=True 表示文件中的值覆盖内核已有的同名变量。默认是 False,已有环境变量优先。
相对路径 ../.env 相对于内核的当前工作目录,并不保证相对于 Notebook 文件所在位置。绝对路径更适合本次排查;换机器后需要调整。
修改 .env 后,依次重跑加载配置、初始化客户端和调用单元格。已有客户端不会自动更新。只输出是否存在密钥,不输出密钥内容。
4. 中转地址的填写方式
SDK 支持环境变量 TYPESAFE_BASE_URL,也支持显式传入 base_url;显式参数优先。
本教程使用的 SDK 路径为 /v1/systemone,因此通常填服务根地址:
填写:https://relay.example.com
请求:https://relay.example.com/v1/systemone
如果完整接口是 https://relay.example.com/typesafe/v1/systemone,则填 https://relay.example.com/typesafe。
中转站必须兼容 TypeSafe 的请求与响应格式。只有 OpenAI /v1/chat/completions 接口的服务,不能仅靠换地址运行这套教程。这里配置的是 API 服务地址,不是系统网络代理。
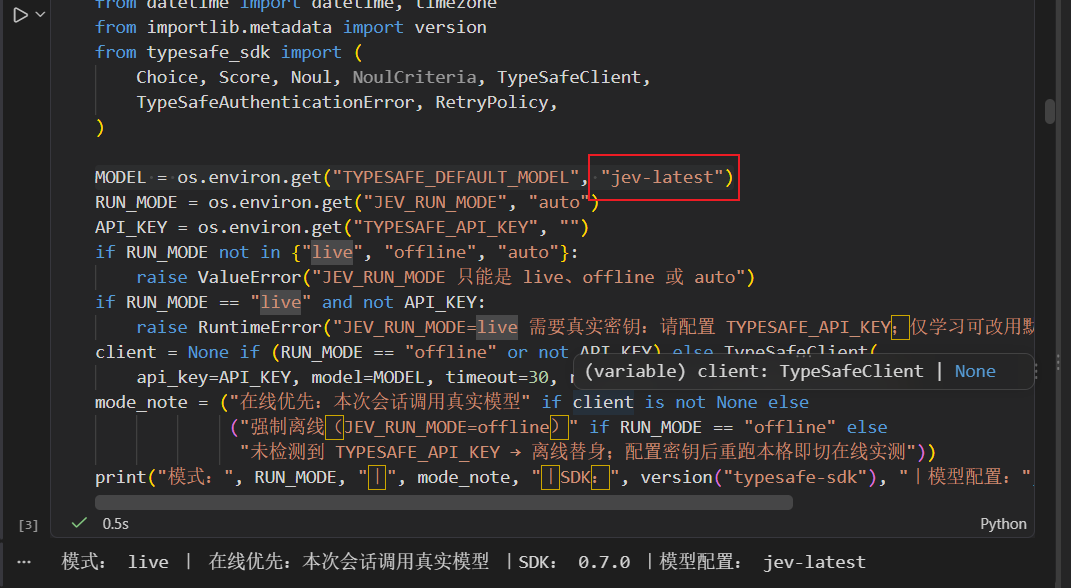
5. 本次遇到的模型名称错误(踩坑)
Notebook 保存的错误为:
422 model must be jev-latest教程默认请求 jev-1.13.0,本次中转服务要求 jev-latest。在 .env 设置 TYPESAFE_DEFAULT_MODEL=jev-latest 后,重新加载并初始化客户端。
PS:这是本次中转服务的要求,不代表所有中转站或官方服务都必须使用这个名称。
四、State 与三种原语
1. State 是判断依据
EXP_STATE = ("用户:我连续三天没能把 Stripe 账户连上,集成一直失败,"
"每耽误一天都在丢订单,请尽快处理!")相邻字符串会自动拼接,EXP_STATE 本身就是一个字符串。Python 不强制写 EXP_STATE: str。
State 提供证据,原语规定问题允许怎样回答。输入不需要标为 Noul、Choice 或 Score;SDK 也可以接收结构化状态,例如字典。
2. 三种原语的区别
原语(Primitive)是构建复杂判断的基本问题类型。
| 原语 | 问法 | 答案含义 |
|---|---|---|
| Noul | 是否成立? | 成立的概率,如是否需要人工 |
| Choice | 属于哪个类别? | 类别选择与各类别概率 |
| Score | 程度有多高? | 有序等级的概率与加权分数 |
Choice 的选项通常没有大小关系,Score 的等级有顺序和业务含义。概率、接口置信度和实际正确率也不是同一个概念,高置信度不保证单次判断正确。
3. 同一份 State 提出三个问题
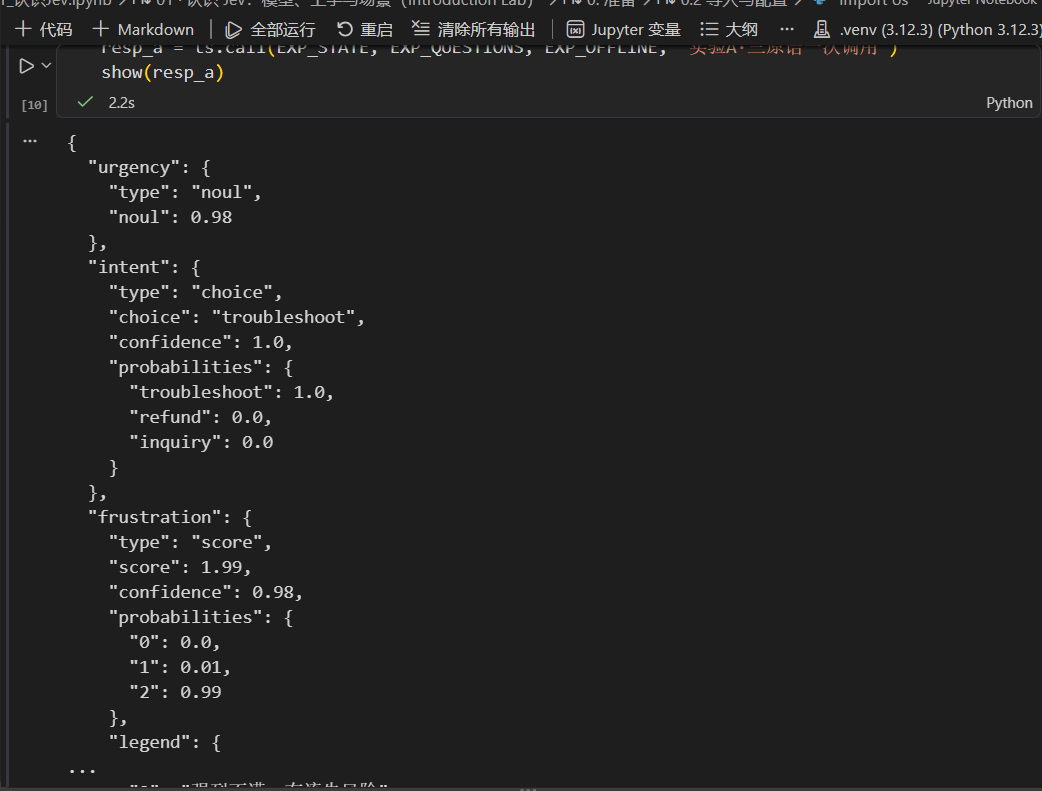
EXP_QUESTIONS = {
    "urgency": Noul(instructions="这条消息是否表达了紧迫性?"),
    "intent": Choice(
        instructions="用户的主要诉求是什么?",
        criteria={
            "troubleshoot": "希望排查或修复连接问题",
            "refund": "要求退款或赔偿",
            "inquiry": "只是咨询,不要求立即处理",
        },
    ),
    "frustration": Score(
        instructions="用户的受挫程度如何?",
        criteria=["平静,仅陈述事实", "有些不满", "强烈不满,有流失风险"],
    ),
}urgency、intent、frustration 是关联返回结果的问题 ID。Noul、Choice、Score 对象分别描述问题和答案空间。
在线时,一次 client.system_one(EXP_STATE, EXP_QUESTIONS) 提交共享证据与三个问题。一次请求不意味着已知服务端内部计算方式,也不能据此断言问题在数学上完全独立。
4. 模型判断与代码策略
假设返回需要人工的概率为 0.93,代码决定是否转人工:
human = response.nouls["requires_human"].noul >= 0.70.7 是应用阈值,需要结合风险和标注样本确定,不是模型自动设定的规则。分类可以读取 .choice,评分可以读取 .score。
五、离线替身如何运作
1. 人工答案模拟返回结构
离线替身是教程提供的人工答案对象,不是本地 Jev 模型,也不会分析输入。
ts.call(state, questions, offline_answers, label)
    ├─ 在线:client.system_one(state, questions)
    └─ 离线:_FakeResponse(offline_answers)
                  ↓
           验证结构、展示结果、执行业务代码
offline_answers 不会发送给在线模型。它只在离线分支使用。
| 模式 | 当前第一章的行为 |
|---|---|
| offline | 强制使用人工答案 |
| auto | 有密钥则在线,无密钥则离线;允许鉴权 401 时回退 |
| live | 必须在线,失败抛出错误 |
其他网络错误、422 等错误不会因为 auto 就自动全部回退。这里描述的是当前第一章,其他 Notebook 以自己的运行说明为准。
2. 为什么使用 _FakeAnswer
"urgency": _FakeAnswer("noul", noul=0.94)这个对象带有 .type 和 .noul 属性,后续代码就能像读取 SDK 答案一样读取它。fake_choice() 与 fake_score() 内部同样创建 _FakeAnswer,还分别计算最大概率类别和加权分数。
_FakeResponse 按类型整理 .choices、.scores、.nouls,将模型标记为“人工示例,非模型预测”,token 数设为 0;调用记录将离线耗时记为 None,避免当成模型性能数据。
3. 三原语实验中的人工答案
EXP_OFFLINE = {
    "urgency": _FakeAnswer("noul", noul=0.94),
    "intent": fake_choice(
        {"troubleshoot": 0.82, "refund": 0.03, "inquiry": 0.15}, 0.8
    ),
    "frustration": fake_score(
        {0: 0.05, 1: 0.35, 2: 0.6},
        ["平静", "有些不满", "强烈不满"],
        0.87,
    ),
}
这些数值都是预先填写的。Choice 选中 troubleshoot,最后的 0.8 是另外填写的置信度,不能理解成最大类别概率。Score 的加权分数为:
$$
\operatorname{score}=\sum_k k p_k
=0\times0.05+1\times0.35+2\times0.6=1.55
$$
其中 $k$ 是等级编号,$p_k$ 是该等级的概率。1.55 表示在所定义等级上的期望分数,不是概率,也不是置信度;0.87 才是另行预设的 confidence。
4. 赛事事件中的 OFFLINE 列表
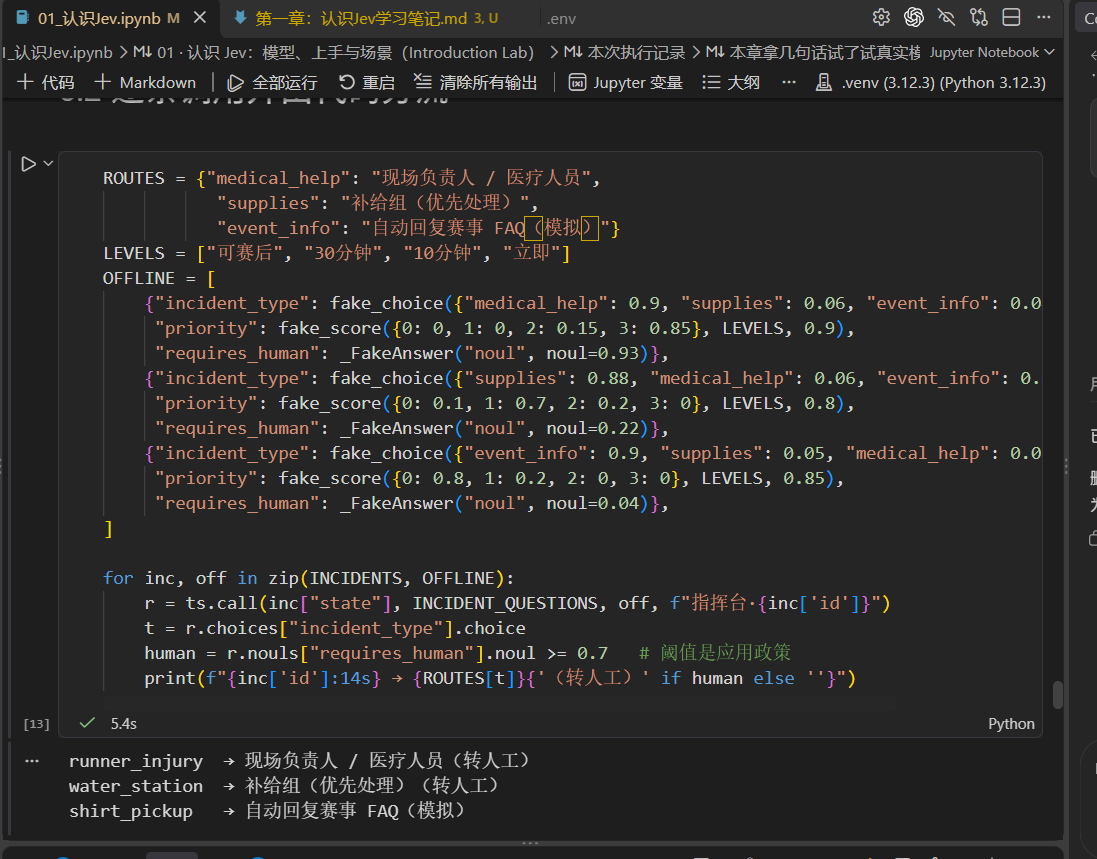
OFFLINE 列表的每个字典对应一条事件,包含类别、优先级和是否转人工三个答案。zip(INCIDENTS, OFFLINE) 将事件与人工答案按顺序配对。
优先级等级为 LEVELS = ["可赛后", "30分钟", "10分钟", "立即"],对应编号 0~3。
| 事件 | 人工选中类别 | 优先级加权分 | 人工处理概率 | 按 0.7 阈值转人工 |
|---|---|---|---|---|
| 第一条 | medical_help | 2.85 | 0.93 | 是 |
| 第二条 | supplies | 1.10 | 0.22 | 否 |
| 第三条 | event_info | 0.20 | 0.04 | 否 |
第一条的优先级计算是 $2\times0.15+3\times0.85=2.85$。这不表示“2.85 分钟”,等级名称中的时间只是业务描述。
PS:离线模式适合学习响应结构和阈值分支。修改 State 后仍使用原人工答案,因此不能用它证明模型理解了新文本,也不能据此报告准确率、校准、速度或成本。
Comments NOTHING